Живой тест голосового AI
Голос ответил за 1365 мс. Правда, не на тот вопрос
Мы попросили ассистента посчитать семь на восемь. Он успел перебить вопрос, переспросить и уверенно решить уже другой пример. Разбираемся, куда делась фраза и почему одной цифре задержки верить нельзя.
Мы попросили голосового ассистента посчитать семь на восемь. Он ответил быстро: сначала попросил закончить вопрос, потом сообщил, что один на восемь — восемь.
На экране горели бодрые 1365 миллисекунд. Очень быстро для неправильного ответа.
01
Один вопрос превратился в два
Тест был нарочно скучным. Голосовой модуль TokenTool, модель Poolside Laguna S 2.1, голос Алёна, обычный ноутбучный микрофон и пауза перед отправкой в 750 мс. Синтезатор Windows произнёс одну фразу через динамики. Никакого звонка, шумного офиса и человека, который жуёт слова.
Мы
Сколько будет семь умножить на восемь? Ответь одним коротким предложением.
Распознавание, первая часть
Сколько будет
Ассистент
Пожалуйста, уточните, что именно вы хотите посчитать.
Распознавание, вторая часть
И не умножить на 8 ответь 1 коротким предложением
Ассистент
1 × 8 = 8.
Два голосовых хода вместе с двумя обращениями к модели стоили 0,8418 ₽. Деньги тут не проблема. Проблема в том, что за эти деньги получился аккуратный разговор ни о чём.
Если ассистент быстро отвечает на обрезок фразы, ускорять модель уже поздно.
02
Математика сломалась ещё до математики
Языковая модель не слышала исходный вопрос. Сначала система решила, что короткая пауза после слов «сколько будет» означает конец реплики, и отправила этот кусок в распознавание. Модель получила незаконченный вопрос и вполне логично попросила уточнить.
Остаток фразы приехал отдельным сообщением. Заодно распознавание превратило «семь» в «и не». После этого ответ «1 × 8 = 8» уже не выглядит загадкой. Модель решила тот пример, который увидела. До настоящего вопроса он не добрался.
Такой сбой плохо ловится тестом в текстовом чате. Там фраза уже собрана, слова написаны правильно и никто не пытается угадать, закончил человек говорить или просто вдохнул.
03
Что на самом деле значит 1365 мс
В интерфейсе TokenTool эта цифра считается после того, как реплика уже отправлена на обработку: распознавание речи, ответ модели и синтез звука. Настроенные 750 мс ожидания тишины в неё не входят.
Поэтому пользователь ждал не 1365 мс, а как минимум 2115 мс: сначала система решала, закончилась ли реплика, потом делала остальную работу. И это время для второго, уже испорченного куска вопроса. Красивый показатель честно измерил только часть неудачи.
750 мс
ожидание тишины до отправки
1365 мс
распознавание, модель и озвучивание
2115+ мс
минимальная ощущаемая пауза
04
Крутилка тишины не умеет читать мысли
Короткая пауза делает ассистента бойким, но он начинает лезть в середину предложения. Длинная бережёт фразы, зато после каждого ответа возникает маленький сеанс спутниковой связи.
Поставить полторы секунды и объявить победу не получится. В нашем контрольном прогоне с более длинной паузой звук вообще не распознался, поэтому приписывать настройке чудесное исправление было бы нечестно. Нужны серии записей: короткие вопросы, адреса, номера, паузы внутри предложения и обычный фоновый шум.
Для нормального разговора одной тишины мало. Система должна учитывать хотя бы промежуточный текст: «сколько будет» похоже на начало мысли, а «сколько будет семь умножить на восемь» — уже на вопрос. Микрофон этого различия не знает.
05
Что здесь вообще можно подкрутить
У голосовой цепочки несколько самостоятельных частей: микрофон, определение конца реплики, распознавание, языковая модель и синтез речи. Менять всё сразу — надёжный способ получить другую ошибку и не понять, почему.
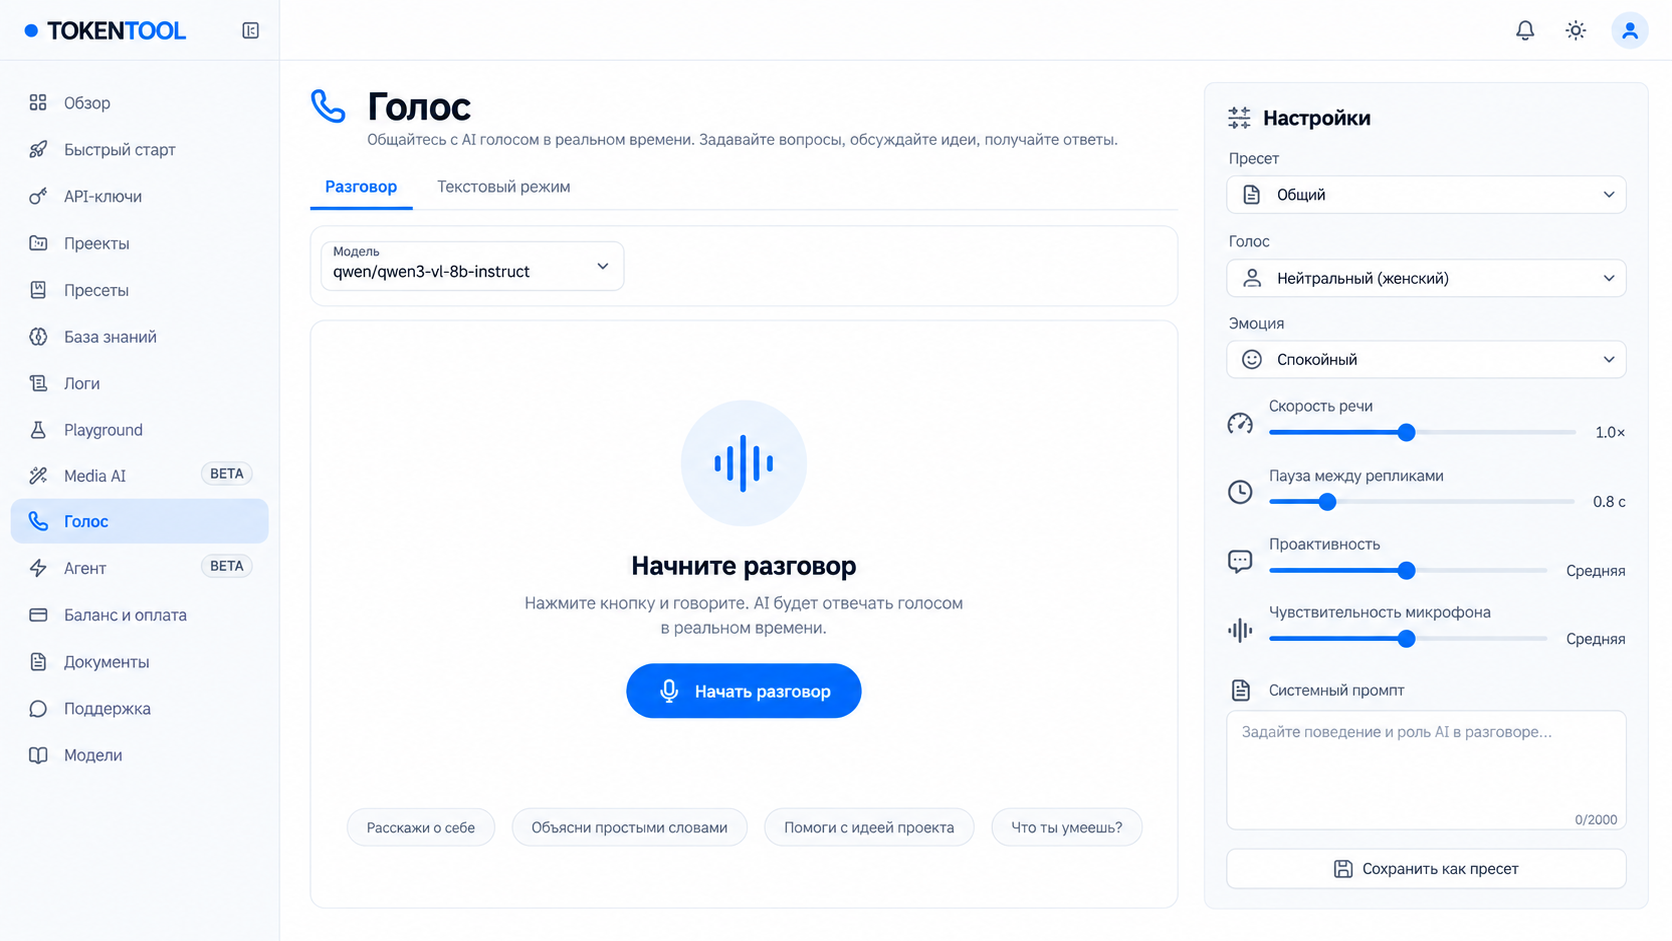
В модуле TokenTool рядом находятся модель, пресет, голос, скорость, пауза и чувствительность микрофона. Транскрипт остаётся на экране. Это полезнее зелёной лампочки «всё работает»: видно, что именно услышала система до того, как обвинять модель.
06
Тест, после которого уже можно звонить людям
Начните с двадцати фраз, которые похожи на настоящие, а не на команду умной колонке. Пусть человек вспоминает номер заказа, диктует адрес, поправляет себя и делает паузу перед важным словом. Сохраните исходную запись, транскрипт, ответ и время до первого звука.
Смотрите не только на среднюю задержку. Считайте обрезанные реплики, неверно распознанные слова и случаи, когда ассистент начал говорить раньше человека. Один бодрый ответ за секунду ничего не доказывает. Один уверенный ответ на чужой вопрос доказывает довольно много.
Повторить этот тест в TokenTool
Зарегистрируйтесь, откройте голосовой Playground и начните с одной фразы с паузой посередине. Меняйте по одной настройке и смотрите на транскрипт. Так быстрее найти причину, чем неделю спорить о том, какая модель «лучше разговаривает».
Этот опыт не измеряет телефонный канал и не доказывает качество всех голосов или моделей. Он показывает одну проверенную вещь: задержка может выглядеть прилично, пока разговор уже развалился.