Qwen 8B на обычном ноутбуке
Локальная Qwen 8B влезла в ноутбук. В задачу — не очень
Запустили 8B-модель целиком на RTX 4070 Laptop, дали ей тот же баг, что облачным моделям, и дождались четырёх ошибок компилятора вместо бесплатной победы.
На тестовом ноутбуке уже лежала Qwen3 8B в четырёхбитном формате. Восемь гигабайт видеопамяти, шестнадцать оперативной — ровно тот компьютер, на котором обычно обещают «свой бесплатный AI без подписок».
Модель действительно загрузилась. Потом получила тот же кэш с семью требованиями, который до этого чинили Kimi, DeepSeek и GLM. Через пятнадцать секунд у нас было 700 токенов, повтор ответа и код, который TypeScript отказался собирать. Бесплатность состоялась. Исправление — нет.
01
Пять гигабайт модели, четыре ошибки компилятора
Проверяли не семейство Qwen вообще, а конкретный community-вариант Huihui Qwen3 8B Abliterated v2 в квантизации Q4_K_M. Файл занимает 5,03 ГБ. LM Studio загрузила его с контекстом 8192 токена и полным переносом на GPU за 13,45 секунды; после загрузки интерфейс показал 4,68 ГБ памяти модели.
Ноутбук
RTX 4070 Laptop · 8188 MiB
15,7 ГБ системной памяти. Модель целиком поместилась в GPU. До этого места реклама локального AI не соврала.
Один запрос
15,56 с · 126 → 700 токенов
Ответ упёрся в лимит, хотя просили только код без Markdown и объяснений. Температура — ноль.
Первый законченный кусок не прошёл даже компилятор: сигнатура функции изменилась, чтение из Map осталось без проверки, а в расчёте TTL появилась переменная, которой нигде нет. Заодно модель начала повторять реализацию. Локальный запуск мы остановили не за плохой стиль, а за четыре конкретные ошибки TypeScript.
Для сравнения: в прежнем прогоне TokenTool модель GLM 5.2 получила тот же публичный интерфейс и те же семь условий, закончила за 6,63 секунды, стоила 2,84 ₽ и прошла все тесты. Один опыт не превращает GLM в вечного чемпиона, а Qwen — в бесполезное семейство. Он показывает цену именно этой попытки: рублей ноль, результата тоже ноль.
Модель поместилась в видеокарту. Работа туда автоматически не помещается.
02
Ответ на «привет» ничего не проверяет
Маленькая локальная модель умеет поддержать разговор, пересказать абзац и написать простую функцию. Для этого ей не надо помнить устройство проекта, выбирать инструмент, читать результат команды и исправлять собственную ошибку.
Вайбкодинг нагружает модель иначе. Клиент добавляет системные инструкции, дерево файлов, куски кода, результаты поиска и историю предыдущих шагов. Один ответ превращается в серию вызовов. Слабое место видно не в первой реплике, а на пятом действии, когда модель забыла исходную задачу или снова чинит уже починенное.
Локальная модель прошла тест, если закончила вашу задачу. Фраза «сервер запущен» проверяет только сервер.
03
Файл модели не равен всей нужной памяти
В официальной библиотеке Ollama у семейства Qwen3 вариант 8B занимает около 5,2 ГБ, 14B около 9,3 ГБ, а 30B и 32B уже примерно 19–20 ГБ. Это размеры упакованных моделей, а не готовая смета вашей видеопамяти.
Движку нужны сами веса, контекст разговора и временные буферы вычислений. Разработчики llama.cpp отдельно показывают память весов, KV-кэша и compute buffer. Чем длиннее контекст и больше одновременных диалогов, тем меньше смысла смотреть только на размер скачанного файла.
Если модель не помещается в видеопамять, часть работы можно отдать оперативной памяти и процессору. Запуск не запрещён. Просто интерактивный помощник иногда начинает отвечать в темпе очень вдумчивой переписки.
04
Что реально унести домой
Таблица ниже задаёт направление, а не выдаёт сертификат совместимости. Итог зависит от архитектуры модели, квантования, длины контекста, движка и того, чем ещё занят компьютер.
| Железо | Реалистичный класс | Годится | Начинает мешать |
|---|---|---|---|
| Ноутбук, 16 ГБ общей памяти | Небольшая 4–8B-модель с сильным сжатием, обычно через CPU или общую память | Черновики, классификация, короткие приватные тексты | Большой репозиторий, длинный агентный цикл, несколько пользователей |
| Видеокарта с 8 ГБ VRAM | 8B в 4-битном формате, если оставить запас под контекст и вычисления | Один пользователь, короткие запросы, узкая повторяемая задача | Длинный контекст и ожидание качества крупной облачной модели |
| Рабочая станция с 24 ГБ VRAM | Некоторые 30–32B-модели в 4-битном формате, но почти без роскошного запаса | Локальный помощник, приватные документы, контролируемая нагрузка | Дешёвый многопользовательский сервис без очереди и обслуживания |
| API | Модели разных размеров без покупки локальной GPU | Редкие тяжёлые задачи, быстрый запуск, смена модели, рост нагрузки | Полностью автономная работа без сети и внешней обработки данных |
05
Маленькая модель не тупая. У неё короткий список хороших работ
Восемь миллиардов параметров могут отлично разбирать простой формат, сортировать обращения или помогать с небольшим файлом. Ошибка начинается со слова «универсальная». Модель получает весь проект, двадцать правил, доступ к инструментам и просьбу самой решить, когда закончить.
Нормальная локальная работа
Извлечь поля, привести текст к формату, искать по приватным заметкам, предложить короткий diff под контролем человека.
Плохое обещание
«Воткните любую 7–8B в агента, и она заменит крупную модель на большом репозитории». Иногда сработает. Планом это не считается.
Проверка простая: возьмите десять своих задач. Считайте не красивые ответы, а завершённые изменения, прошедшие тесты. Добавьте число повторов и время человека на исправления. После этого спор о параметрах обычно становится короче.
06
Нулевой счёт за токены не означает нулевую цену
У локального запуска есть покупка железа, электричество, место на диске, драйверы, обновления, наблюдение и время на подбор квантования. Для домашнего эксперимента это хобби. Для сервиса с пользователями это уже эксплуатация.
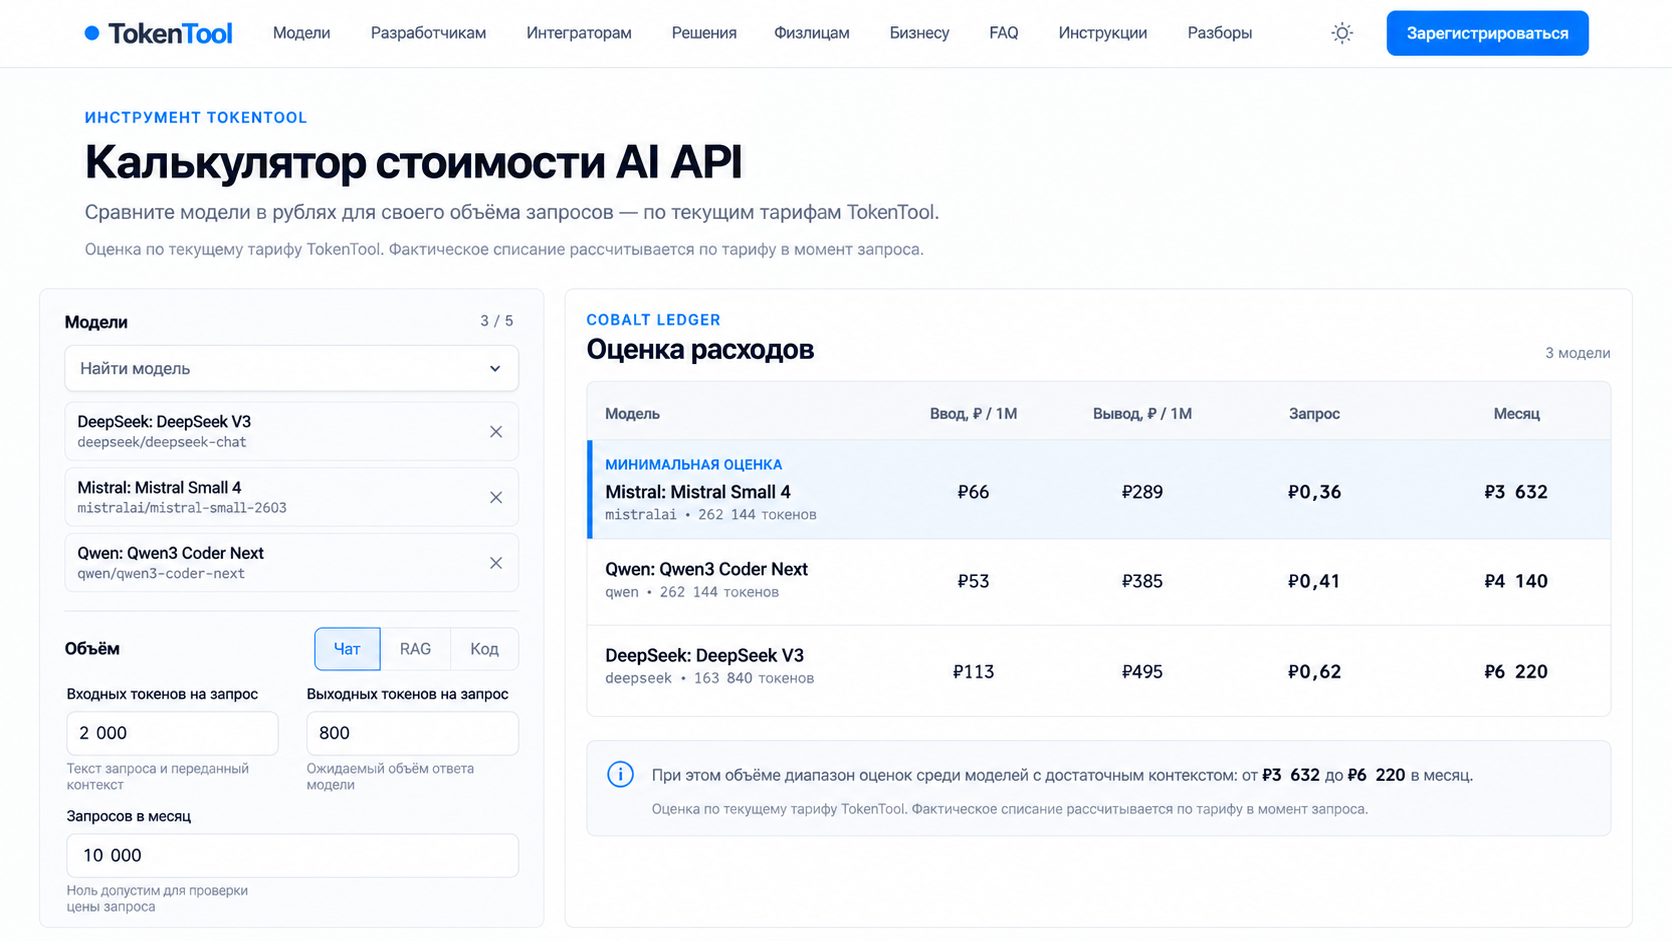
API берёт деньги за использование, зато тяжёлая машина не простаивает под столом двадцать три часа в сутки. Если запросы редкие или нагрузка скачет, покупка GPU может окупаться примерно никогда. Если одна узкая модель занята постоянно и железо уже есть, арифметика меняется.
07
Когда локальная модель действительно выигрывает
Она полезна без оговорок, если данные нельзя отправлять наружу, интернет отсутствует, задержка сети критична или одна стабильная узкая задача выполняется постоянно. Ещё лучше, если подходящее железо уже куплено и есть человек, который умеет его обслуживать.
Для прототипа, редкой тяжёлой задачи и постоянно меняющихся требований API обычно короче. Гибрид тоже нормален: локальная модель чистит и классифицирует данные, удалённая разбирает сложный случай. Архитектура не обязана приносить присягу одному лагерю.
Сначала задача, потом способ запуска
В TokenTool можно сравнить доступные удалённые модели на одинаковой форме запроса и оценить месячный расход. Для локального кандидата проведите тот же набор тестов у себя. Победитель должен лучше решать работу целиком, а не красивее отвечать на один вопрос.
На 15 сентября 2026 года в публичном каталоге TokenTool рабочими отмечены маршруты DeepSeek, Qwen, Kimi, GLM и другие. GPT и Claude в эту рекомендацию не включены. Статус меняется, поэтому перед интеграцией всё равно нужен короткий проверочный запрос.